DataForge 是面向政企客户的一站式高质量数据集生产与运营平台,以数据治理为底座、AI 标注为核心、飞轮闭环为引擎,集数据接入、智能标注、质量评测、合规审查、血缘追踪与数据飞轮于一体,让数据从「可用」到「好用」。
核心特征

数据治理为底座:元数据、血缘、版本与标准统一管控
AI 标注为核心:人机协同,预标注驱动人工校验
飞轮闭环为引擎:BadCase 自动回流,模型越用越好
七位一体:接入 / 治理 / 标注 / 质检 / 合规 / 交付 / 飞轮回流全打通
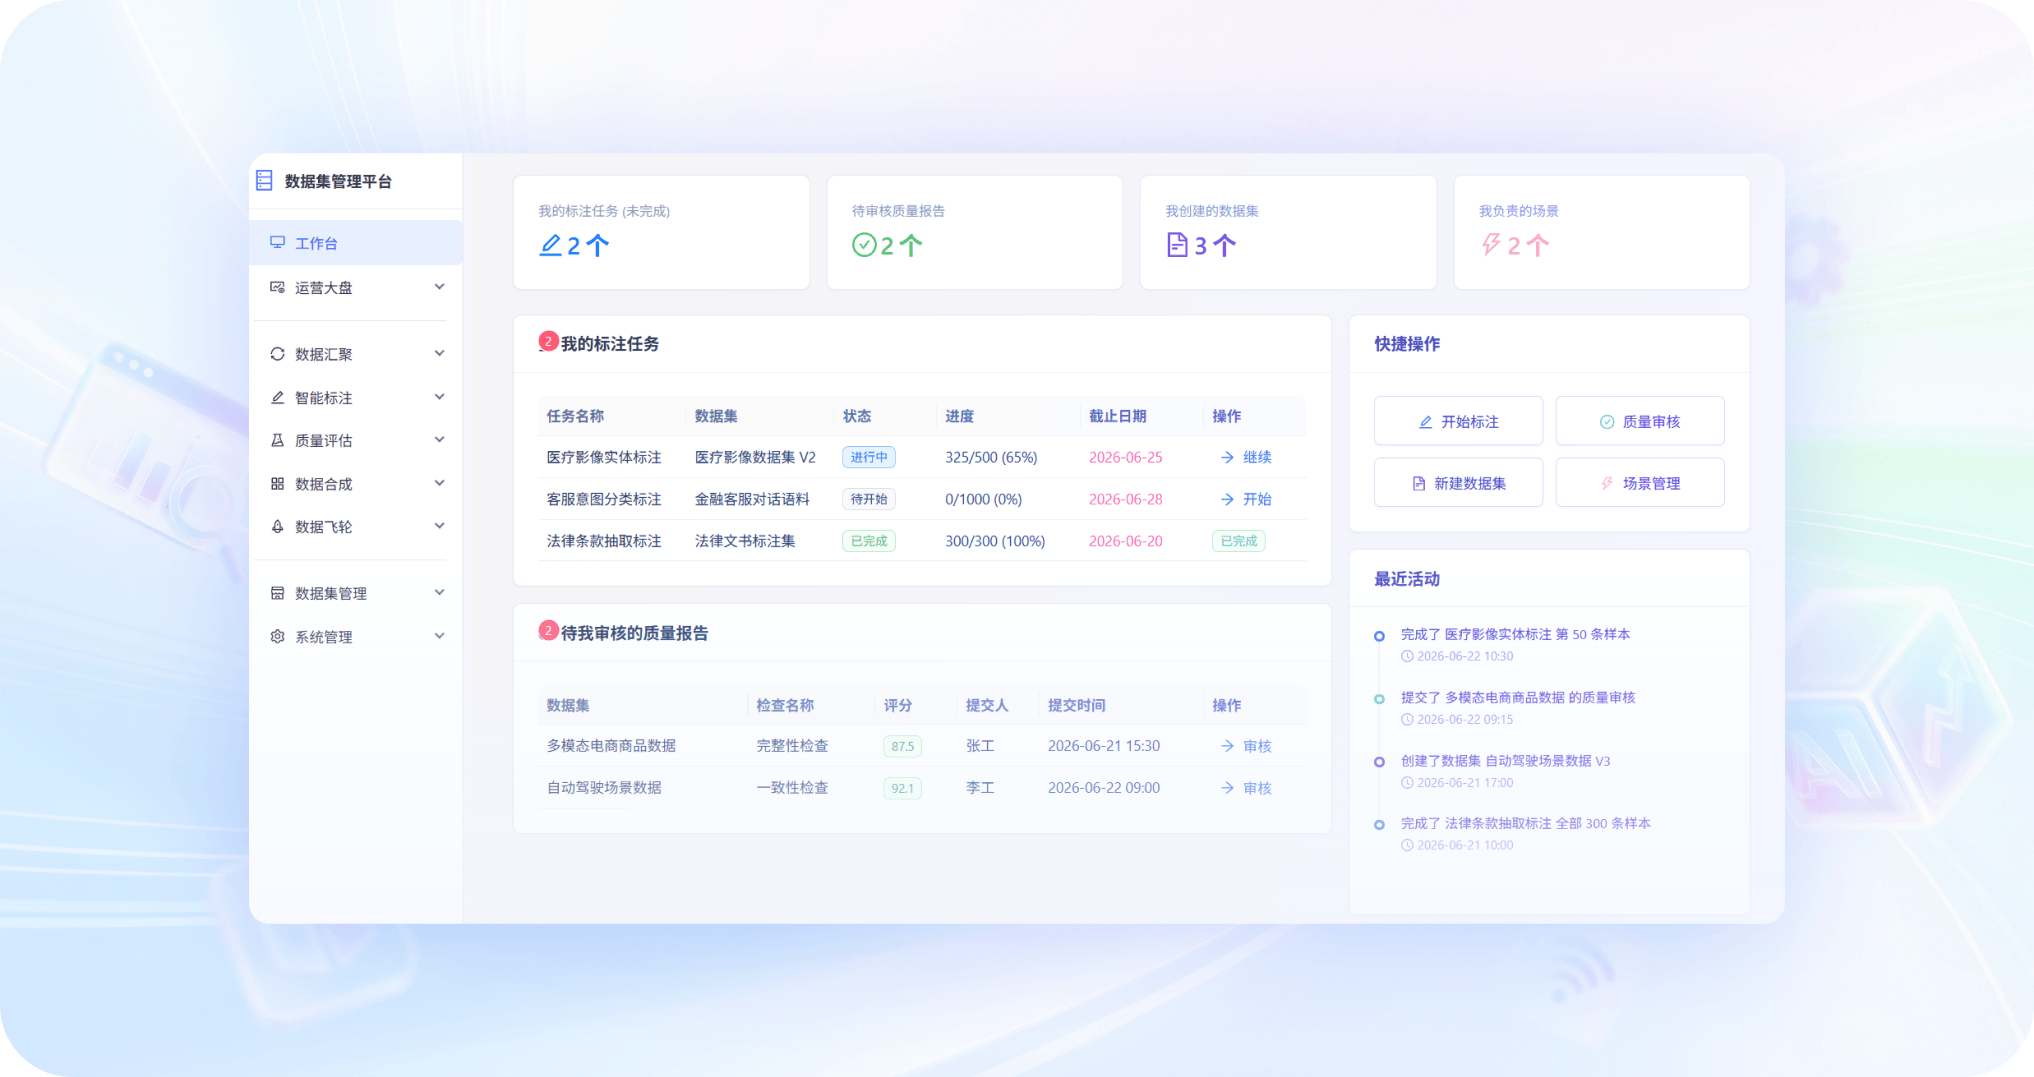
六大核心功能模块
数据汇聚
多源数据接入
打通 7 类数据源,将散落各处的原始数据统一接入、协议适配并可靠归集到底层存储,为治理与标注提供一致的数据基础。
- 多源接入:MySQL / PostgreSQL / MongoDB / API / S3 / Kafka / 文件,向导式配置+一键测试连接
- 批量 ETL:Apache Airflow 编排,DAG 可视化,对接 AI/ML 生态
- 统一接入网关:APISIX 鉴权 / 限流 / 动态路由,对外提供 REST API / SDK / Webhook
智能标注
人机协同标注工场
多模态标注工作台,AI 预标注与人机协同提升产能。
- 多模态:图像 / 文本 / 音频标注类型
- AI 预标注 + 置信度,人工抽检校正反馈闭环,主动学习:低置信度样本优先推送
- 质检:Cohen's Kappa 一致性、双重质检 + 专家仲裁
质量评测
三级质量评测中心
三级评测体系,把“好数据”从主观判断变为可量化标准。
- L1 基础质量:完整性/一致性/准确性/时效性,L2 行业质量:医疗 HIPAA、金融监管等插件,L3 AI 适用性:标签一致性、分布平衡、偏差检测
- 数据漂移检测(PSI/KS)+ 质量分 ≥85 才准发布
数据合成与增强
多策略合成与增强
在珍贵/敏感数据不足时,合规扩充训练样本。
- 统计合成:SMOTE 过采样、差分隐私、同义词替换,生成合成:LLM 文本、回译、Diffusion 图像,仿真合成:3D 点云、传感器物理仿真
- KS 检验比对分布,输出合成质量报告
数据飞轮
闭环飞轮运营
行业的四环闭环运营机制,把"交付即结束"的单向流水线变为越用越好的自驱飞轮,让数据集与模型效果持续协同迭代。
- 四环闭环:场景牵引 → 数据构建 → 应用验证 → 反馈迭代,飞轮周期 < 4 周,失败案例回采率 > 90%
- 自动化能力:失败案例自动回采、难例主动推荐、数据集自动版本更新、预警告警
合规与安全
合规安全围栏
以合规为底座,企业始终掌握数据主权。
- PII 检测:手机号/邮箱/身份证/姓名等 6 类,脱敏:redact / SHA256 / partial_mask / 差分隐私
- 权限:RBAC(7 角色)+ ABAC(数据集/字段/操作级)
- 审计:SHA-256 哈希链 + APPEND-ONLY 不可篡改
全链路闭环 · 一端到端的闭环
市场尚无产品同时覆盖 7+ 环节。
DataForge 将数据接入、治理、标注、质检、合规、交付到飞轮回流一次性打通,彻底告别多工具拼接。
01数据接入
多源汇聚

02数据治理
标准/血缘/版本
03智能标注
AI+人工协同
04质量评测
三级质检
05合规审查
脱敏/审计
06交付应用
数据集市场
07飞轮回流
BadCase 回采


飞轮回流:线上 BadCase 自动回流入训练集,4 周完成一轮「采集 → 标注 → 训练 → 评估 → 补采」,驱动模型持续进化
四大差异化定位
全链路贯通
接入→治理→标注→质检→合成→飞轮→合规,单平台完成,环间数据结构互通

人机协同标注
AI 预标注(置信度)+ 人工确认 + 多人仲裁 + Kappa 一致性检验一体化

数据飞轮闭环
线上 BadCase 自动回流入训练集,4 周完成一轮采集-标注-训练-评估-补采

合规沙箱与自动化审计
全流程 WORM 审计 + ABAC + 隐私计算 + 分类分级 + 合规报告的方式,让数据集在受控沙箱内加工、审计留痕自动生成

应用场景
政务数据 / 公共数据运营
有效解决:行业高质量数据集建设试点、公共数据授权运营
金融科技
有效解决:风控模型训练数据构建、反欺诈数据集、智能投研数据整理
医疗健康
有效解决:医疗影像标注、病历结构化、临床试验数据治理
智能制造
有效解决:工业质检数据治理、缺陷样本库、设备故障预测数据集
核心用户群